Hacer un cover con IA no tiene por qué sonar artificial ni convertirse en un lío técnico. Con ACE Studio puedes coger cualquier canción y convertirla en una nueva interpretación vocal de calidad profesional, con voces de IA expresivas y un proceso pensado para gente creativa, no para programadores. Los flujos de trabajo tradicionales dependen de varios plugins; ACE Studio lo reúne todo en una sola interfaz. Puedes separar las pistas, elegir un modelo de voz expresivo y crear una nueva capa vocal controlando con precisión el timing y el tono, sin salir de la sesión.
En esta guía repasamos el proceso completo, desde aislar la voz hasta dar forma a la interpretación y exportar el cover final.
¿Qué es un cover de canción con IA?
Un cover de canción con IA es una pista vocal nueva hecha con una voz sintética en lugar de con un cantante en directo. No se graba otra interpretación: el sistema aprende el fraseo, la melodía y la emoción del original y los reproduce con otro carácter vocal, que puede ser una voz genérica, un personaje estilizado o un modelo personalizado.
Si los covers con IA se han extendido, es más por lo accesibles que son que por la novedad. Grabar en estudio suele exigir cantantes, equipo especializado, un espacio adecuado y tiempo. Las voces sintéticas permiten experimentar con el sonido de forma rápida y barata: llevar una canción a otro idioma, probar fraseos o prototipar una idea.
Se usan en reels de demostración, remezclas creativas, producción en fase temprana y versiones de fans de canciones conocidas. Lo que gusta de ellos es lo rápido que permiten iterar y probar cosas antes de decidirse por una toma final.
Que una voz de IA suene realista depende de dos cosas: lo bien que se quite la voz original de la mezcla y lo natural que suene la nueva. En ACE Studio los dos pasos forman parte del mismo flujo de trabajo, así que es más fácil mantener la claridad y el timing de principio a fin.
Cómo hacer un cover con IA en ACE Studio
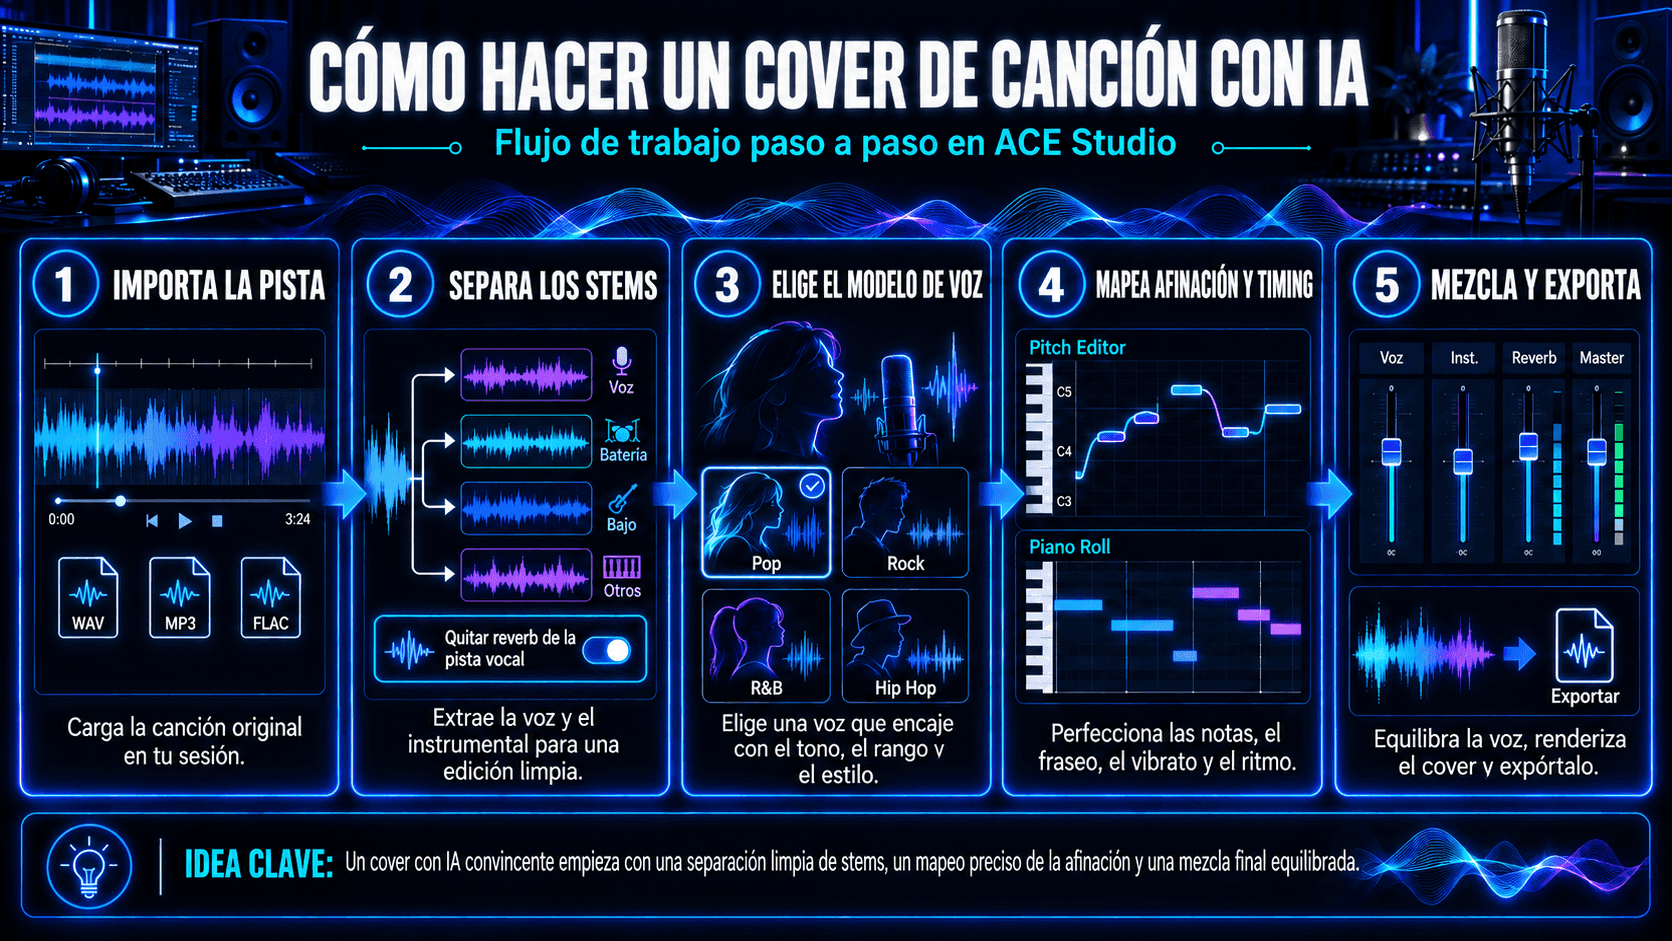
En ACE Studio el proceso sigue un orden fijo: aislar la voz de la canción original, elegir un modelo de voz sintética y guiar ese modelo para que cante la misma melodía con el mismo fraseo, pero con otro timbre. De cada uno de estos pasos depende en buena parte lo realista y musical que suene el resultado.
Paso 1: importar la pista
Abre una sesión en ACE Studio y carga la canción con la que quieres trabajar. Admite formatos habituales como WAV, MP3 y FLAC, y el audio aparece directamente en la línea de tiempo. No hay que convertir nada ni configurar plugins; todo está dentro de la sesión.
Paso 2: separar voces e instrumental
Para sustituir la voz original, primero hay que extraerla. De eso se encarga el separador de stems de ACE Studio, que divide la canción en capas editables: voz principal, batería, bajo y contenido armónico. Si la voz tiene reverb o efectos superpuestos, activa la opción "Remove Reverb for Vocal Track" para reducir interferencias y que la detección de la afinación sea más precisa. La separación respeta la fase y el timing, así que la canción sigue intacta a nivel musical y queda lista para las voces nuevas.
Paso 3: elegir un modelo de voz
Con el stem vocal ya separado, toca elegir la voz sintética que hará el reemplazo. ACE Studio tiene varios modelos preentrenados, cada uno con su propio tono, rango y nivel de detalle expresivo. Están pensados para música y responden a las guías de afinación y fraseo.
Para usos más avanzados, como emular a un artista o proyectos de marca, puedes entrenar un modelo personalizado con tus propias grabaciones de voz. Así controlas por completo el color vocal, el vibrato, la articulación y los rasgos de estilo.
Paso 4: mapear la interpretación vocal
La voz sintética necesita una guía. ACE Studio crea automáticamente un mapa de afinación y timing a partir del stem vocal extraído. Ese mapa le indica al modelo cuándo entrar, qué nota cantar y cómo frasear cada sílaba. Puedes editarlo en el Pitch Editor para corregir la duración de las notas, el vibrato o la precisión rítmica, algo que viene bien sobre todo en interpretaciones complejas o muy estilizadas.
Una vez aplicado, la voz de IA canta la melodía con un timbre nuevo y conserva el flujo de la interpretación original. Si aparece alguna incoherencia o algún artefacto, se puede corregir de forma no destructiva en la misma sesión.
Paso 5: finalizar y exportar
Cuando el fraseo y la mezcla te convenzan, renderiza la nueva voz como archivo de audio e intégrala con el resto de la sesión. En la línea de tiempo puedes seguir editando y mezclando, por ejemplo ajustar el balance o añadir algún efecto discreto. ACE Studio también tiene medición de sonoridad (loudness) y opciones de exportación tanto para archivar en alta resolución como para publicar contenido.
Si el cover parte de una composición con derechos de autor, puede que necesites permisos de uso antes de distribuirlo. Con material libre de regalías o con obras propias, el resultado se puede usar directamente.
Problemas habituales al hacer covers con IA (y cómo solucionarlos)
ACE Studio simplifica la síntesis vocal, pero para conseguir un buen resultado sigue haciendo falta entender cómo interpreta el sistema la afinación, la ganancia, el timing y el fraseo. A veces el fallo no es técnico, sino que viene de una entrada irregular o de un ajuste que se pasó por alto. Estos son algunos problemas que aparecen a menudo y cómo resolverlos dentro de ACE Studio.
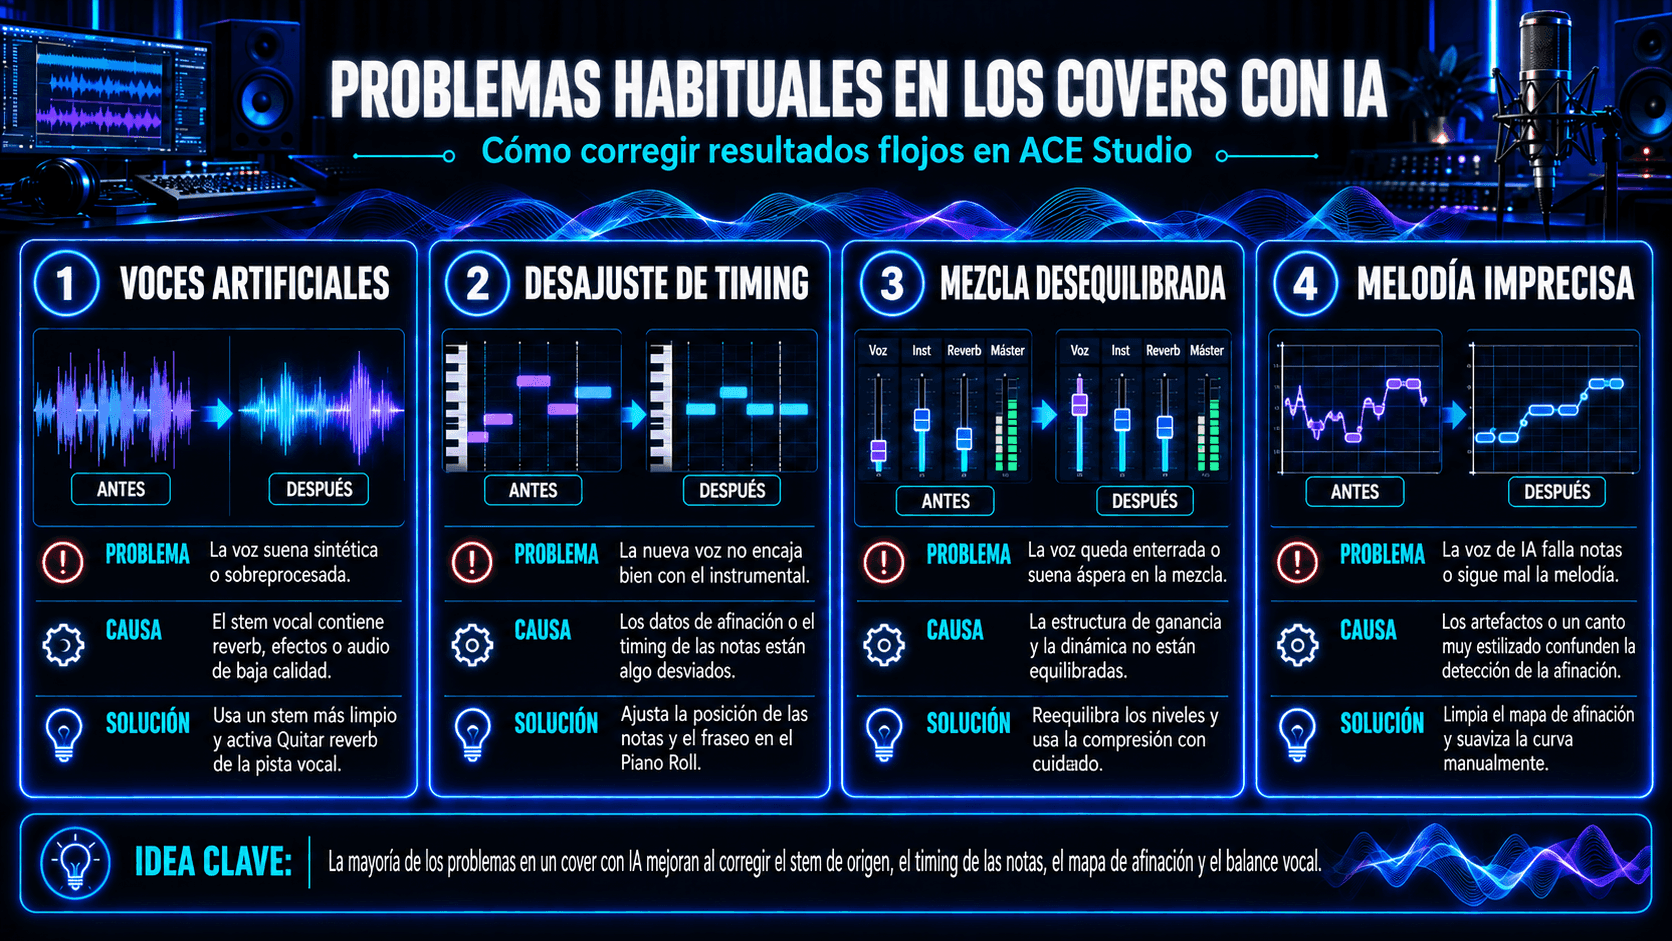
La voz suena artificial o sobreprocesada
Uno de los problemas más comunes es que la voz generada pierda claridad o suene demasiado sintética. Casi siempre tiene que ver con la calidad del stem vocal de entrada. Si la pista original lleva efectos superpuestos, como ensanchamiento estéreo, delay slapback (un eco corto) o reverb, al sistema le cuesta detectar la curva de afinación natural y el resultado sintetizado sale con artefactos.
Lo mejor es atajarlo al separar los stems. Al configurar la separación, activa "Remove Reverb for Vocal Track" para quitar efectos espaciales y ambiente de fondo; así el sistema recibe una referencia vocal más limpia. Conviene evitar también formatos comprimidos como los MP3 de bitrate bajo, que aplanan los matices de la entonación y restan precisión a la afinación. Un stem en alta resolución, mejor en WAV o FLAC, da una afinación más fiel y transiciones de formantes más suaves al renderizar.
El timing entre stems está desalineado
A veces la nueva voz no encaja rítmicamente con el instrumental. Basta un pequeño retraso o una irregularidad para que el resultado suene descoordinado. Suele pasar cuando el mapa de afinación extraído no coincide con la cuadrícula de la sesión o cuando el audio importado arrastra variaciones de tempo de una producción anterior.
ACE Studio no tiene, por ahora, alineación automática de las notas a la cuadrícula, pero sí un control manual detallado para corregir el timing. En el Piano Roll puedes mover notas, ajustar el timing de cada sílaba y retocar el fraseo con las herramientas de afinación. Por ejemplo, puedes desplazar el inicio de una nota, añadir o suavizar ataques y retocar las curvas de afinación para que vayan más a tempo.
Lo que hay que vigilar es que el tempo de base se mantenga constante en toda la sesión, porque un BPM que no cuadra o una automatización de tempo provocan desajustes de timing pequeños, pero que se notan.
La mezcla final suena desequilibrada
Es normal que las voces sintetizadas queden demasiado bajas o demasiado altas frente al instrumental. Casi siempre tiene menos que ver con la síntesis que con la estructura de ganancia (gain staging) de la sesión. Si la ganancia de base de la pista vocal está muy baja, la voz pierde presencia y se queda enterrada en la mezcla. En el otro extremo, llevar la afinación o los formantes demasiado lejos del rango natural del modelo puede generar transitorios agudos que suenan ásperos o incluso saturan (clip) al reproducir.
En ACE Studio la ganancia se ajusta en varias fases. El mezclador principal controla directamente el volumen de cada pista, así que puedes reequilibrar sobre la marcha. Para ajustes centrados en la voz, el panel VocalEffect tiene un compresor con control de ganancia, útil para dar presencia a la voz sin subir demasiado la salida general. Los medidores del mezclador reaccionan al momento a cada cambio, lo que ayuda a comprobar que todo está equilibrado antes de exportar.
Eso sí, ACE Studio no incluye todavía un analizador de sonoridad ni un limitador suave en la exportación. Por eso, si vas a publicar el tema, merece la pena acabar la mezcla vocal en un DAW. Una compresión ligera o un limitador después de la síntesis mantienen la claridad y la coherencia del sonido en distintas plataformas de reproducción.
La melodía suena incorrecta o imprecisa
A veces la voz de IA no sigue del todo la melodía prevista, y el origen suele estar en el mapa de afinación. Puede deberse a restos de otros instrumentos que se cuelan en el stem vocal al separarlo (sangrado) o a recursos de canto estilizados, como un vibrato muy marcado, deslizamientos de afinación o armónicos superpuestos. Todo eso confunde la detección de afinación de la IA, que acaba cantando notas incorrectas o poco precisas.
ACE Studio permite ajustar la curva de afinación al detalle antes de sintetizar. En el Pitch Editor puedes suavizar la curva a mano con el Pitch Brush y los Anchors, borrar notas que sobran o retocar transiciones, algo muy útil en pasajes con melismas o cambios microtonales. Las sílabas sin afinación definida, las respiraciones o los ruidos glotales pueden aparecer como notas falsas; si los eliminas o los suavizas, la melodía se reproduce más limpia.
Con la melodía bien definida en el mapa de afinación, las curvas sueltas suavizadas y el ruido eliminado, la voz de IA sigue la línea musical prevista con más precisión y expresividad.
Consejos avanzados para que las vocales IA suenen más realistas
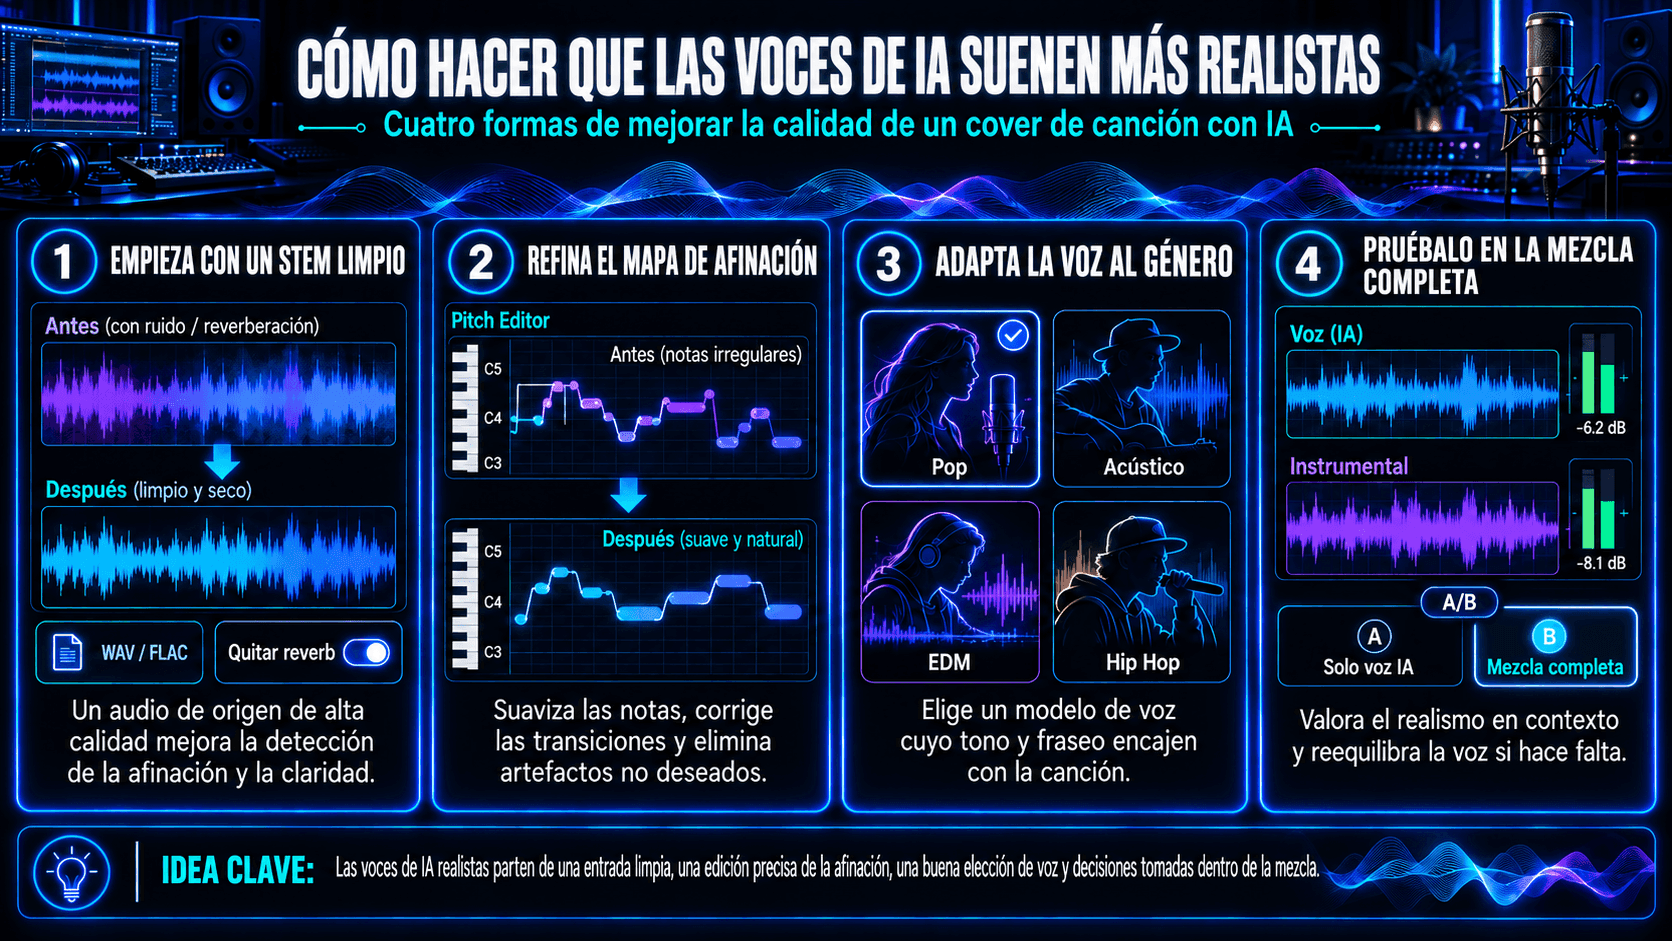
Refina la pista vocal antes de renderizar
Las voces sintéticas más creíbles salen de un stem vocal limpio y bien definido. El separador de stems de ACE Studio hace la separación de forma automática, pero a la voz extraída le suele venir bien un repaso en el Pitch View Editor. Si limpias los armónicos que sobran, el ruido de fondo o los datos de afinación mal detectados, la IA recibe información clara sobre la melodía y el fraseo.
El formato también influye. Con archivos en alta resolución, como WAV o FLAC, se nota la diferencia; los comprimidos o en mono pueden perder los transitorios y los detalles armónicos que hacen falta para modelar los formantes con naturalidad. Para reducir interferencias en la detección de afinación, activa "Remove Reverb for Vocal Track" al separar los stems.
Elige el modelo de voz según el género
No todos los géneros funcionan igual con voces sintéticas. Los estilos con dicción clara y fraseo previsible, como el pop, el K-pop o las baladas acústicas, suelen dar mejores resultados que los de dicción muy rápida, con distorsión o con un procesado vocal extremo.
Con géneros rápidos como el hip hop o el metal, simplifica las líneas vocales antes de sintetizar. Dividir las frases largas en trozos más cortos y ajustar con más precisión la cuadrícula de tempo ayuda con la alineación. También conviene elegir un modelo que encaje con el tono del género, por ejemplo voces con más aire para lo-fi o con una dinámica más controlada para EDM. El resultado gana en realismo y coherencia.
Ajusta los parámetros de síntesis por sección
Trata cada sección de la canción como una interpretación distinta. A los estribillos les puede venir bien un vibrato más largo y transiciones más suaves, mientras que las estrofas suelen pedir una articulación más nítida y un fraseo más ceñido. ACE Studio permite editar cada región por separado en su propia pista de afinación, con control preciso sobre el timing de las notas, el vibrato y la expresión.
Cambios pequeños, como mover el inicio de una nota o variar la profundidad del vibrato, hacen que una interpretación sintética suene bastante más natural, sobre todo en el paso de una frase a otra.
Prueba en contexto, no en aislamiento
Editar las voces en solo puede engañar. Algo que suena robótico por sí solo puede encajar perfectamente en la mezcla, y al revés. Haz siempre pruebas A/B con el instrumental sonando para valorar el equilibrio, el enmascaramiento y la sonoridad percibida.
Si la voz queda enterrada, prueba a mover ligeramente el registro o a aplicar saturación armónica para darle presencia sin subir el volumen. Evita comprimir en exceso: aplana los matices de la voz, y las voces renderizadas por IA ya tienen menos matices que las humanas.
Cómo usar, compartir o publicar tu cover hecho con IA
Cuando ya has generado y pulido el cover en ACE Studio, falta decidir cómo y dónde usarlo. Estas voces no sirven solo para demos. Según el proyecto y los derechos de la composición original, tienen cabida en trabajos creativos, educativos y comerciales.
Prototipado y preproducción
A los productores, los covers con IA les permiten probar decisiones de arreglo antes de grabar voces en estudio. Puedes escuchar cómo sonaría una composición con distintas voces, tonalidades o tonos emocionales sin contratar a cantantes ni montar sesiones de grabación. Los datos de afinación y timing que se usaron para generar la voz de IA se pueden reutilizar después con un cantante real, de modo que el borrador y la grabación final mantienen la continuidad.
Funciona especialmente bien en demos tempranas y en colaboraciones de composición. En vez de mandar la letra y los acordes por escrito, los colaboradores reciben la canción ya cantada, con el ritmo y el fraseo que tenías en mente.
Usos educativos y de práctica
Las voces de IA sirven tanto para enseñar como para aprender. Los profesores pueden generar material vocal para ejercicios de mezcla, armonía o afinación vocal sin tener que grabar tomas nuevas. Como ACE Studio permite cambiar el fraseo o la dinámica con facilidad, también es más sencillo aislar un concepto musical concreto durante la práctica.
Los alumnos, por su parte, pueden experimentar con arreglos vocales e ingeniería de audio usando stems limpios y estables. Así se centran en técnicas como la ecualización o el enrutamiento de efectos sin tener que lidiar con grabaciones vocales imprevisibles.
Contenido online y remezclas creativas
Quienes crean contenido para vídeo, pódcast o formatos cortos pueden usar covers con IA para sacar versiones nuevas de canciones conocidas, adaptar la letra a otros idiomas o llevar un tema a otro género. Son versiones distintas que no se alejan de melodías que la gente ya reconoce.
Si el cover parte de una canción con derechos de autor, hay que asegurarse de tener los permisos de uso correspondientes. ACE Studio exporta el audio a resolución completa, así que, una vez resuelta la parte legal, los covers se pueden subir directamente a plataformas como YouTube, TikTok o SoundCloud.
Reproducción en directo e integración en actuaciones
En directo, las voces generadas por IA pueden hacer de voz provisional, pista de acompañamiento o capa de armonías. A los artistas en solitario o a los DJ, sustituir la voz principal por una voz personalizada les da más control sobre el timing, la afinación y la tonalidad, sobre todo cuando buscan una estética vocal concreta que no tienen a mano.
Como el sistema exporta stems alineados y con un timing constante, la mezcla final se integra sin problemas en un DAW o en el equipo de directo. Con control MIDI o sistemas de reproducción sincronizada, un cover con IA puede formar parte de un espectáculo híbrido que mezcla actuación en tiempo real y elementos sintéticos.
Preguntas frecuentes
¿Puedo usar covers de canciones con IA con fines comerciales?
Sí, puedes monetizar las voces generadas con IA en ACE Studio, porque los modelos de voz integrados están libres de regalías y tienen licencia para uso comercial. Pero ojo: si haces un cover de una canción que no has escrito tú, sigues necesitando la licencia de la composición (normalmente una licencia mecánica). ACE Studio no gestiona los permisos de derechos de autor de obras publicadas; conseguirlos es responsabilidad tuya. Si el cover es de una obra tuya o de una pista marcada expresamente como libre de regalías, no hay restricciones para distribuirlo ni monetizarlo.
¿Los modelos de voz de ACE Studio tienen derechos de autor?
Los modelos de voz de ACE Studio tienen licencia para usarse dentro de la plataforma, no para extraerlos ni clonarlos fuera del software. Si entrenas un modelo de voz personalizado con tus propias grabaciones usando las herramientas de ACE, los derechos sobre lo que genere ese modelo son tuyos y puedes usarlo libremente, también con fines comerciales.
¿El cover con IA se ajusta automáticamente al tempo y a la afinación?
Sí. ACE Studio usa una guía interna de afinación y timing que traslada la melodía y el ritmo de tu voz original al modelo de voz elegido. La voz sintetizada se alinea sola con el instrumental, salvo que decidas editarla. El fraseo, el timing y las notas se pueden ajustar a mano en el Pitch Editor o en el Piano Roll.
¿Se puede hacer un cover con IA bilingüe o multilingüe?
Sí. ACE Studio admite varios idiomas (inglés, chino, japonés y español) y su diccionario de fonemas gestiona el cambio de uno a otro. Puedes asignar un código de idioma distinto a cada sección del cover y tener una interpretación fluida en varios idiomas dentro de una sola pista.
¿Cómo se tratan mis datos durante el procesamiento?
Los archivos de tu proyecto, incluidos el MIDI, la letra y el resto de entradas, se guardan en local en tu dispositivo. Durante la síntesis vocal, sin embargo, el servidor en la nube de ACE Studio accede temporalmente a esas entradas para generar las voces de IA. Es decir, el MIDI y la letra se envían a la nube solo para procesarlos. Ninguno de esos datos se guarda en el servidor: se borran de forma automática y permanente en cuanto termina la síntesis. Si trabajas en un proyecto con la sesión iniciada, puedes guardar los resultados generados en local.
¿Qué hace que un cover sea "realista" cuando hablamos de IA?
Un cover con IA realista depende de unos datos de afinación limpios, transiciones de fonemas precisas, un vibrato controlado y un timing rítmico constante. ACE Studio tiene herramientas como el Pitch Editor, el control de vibrato, el suavizado de la afinación y los ajustes de timing para pulir cada uno de estos aspectos, que son los que hacen creíble una voz sintética.